Race Condition
서로 다른 Thread에서 같은 메모리를 공유할 때 같은 자원을 사용하면서 값이 이상하게 되는 것을 race condition이라고 한다.
시작하기에 앞서 모든 STL들은 기본적으로 멀티스레드 환경을 제공하지 않는다고 알아야 한다.
void worker(int& counter) {
  for (int i = 0; i < 10000; i++) {
    counter += 1;
  }
}

int main() {
  int counter = 0;

  vector<thread> workers;
  for (int i = 0; i < 4; i++) {
    // 레퍼런스로 전달하려면 ref 함수로 감싸야 한다.
    workers.push_back(thread(worker, ref(counter)));
  }

  for (int i = 0; i < 4; i++) {
    workers[i].join();
  }

  cout << "Counter 최종 값 : " << counter << endl;
}- 같은 자원을 공유한다고 해서 여기서는 더하기만 하니까 어차피 스레드1에서 더하나 스레드2에서 더하나 순서가 중요하지 않다. 따라서 결과를 확인해보면 40000이 나올것이다.
- 라고 생각할 수 있는데 실제로 호출해보면 이상한 값이 나온다.
- 여기서 중요한 점은 Race Condition은 같은 변수를 다른 값으로 바꿀때 생기는 것 뿐만 아니라 단순히 값을 올리는 작업을 할때도 발생한다는 점이다.
아니 스레드1에서 3을 대입하려고 하고 스레드2에서 5를 대입하려고 하는 상황이 아니고 그냥 서로 더하기만 하는데도 오류가 생긴다고? 이건 뭔가 잘못됐다.
이거를 이해하기 위해서는 counter+=1이 실제로 어떻게 수행되는지를 알아야 한다.
mov rax, qword ptr [rbp - 8]
mov ecx, dword ptr [rax]
add ecx, 1
mov dword ptr [rax], ecx- Assambly코드로 보면 이해가 쉽다.
rax,rbp는 둘다 CPU 레지스터를 의미한다.qword는 8바이트를 의미한다. -> 주소값의 크기를 의미.dword는 4바이트를 의미한다. -> int값의 크기 등등[]의 의미는 역참조다. 즉,rbp - 8이라는 주소에 있는 값을 읽어라 라는 뜻이고 c++의*와 같은 것이다.mov는 이 문장이 어떤 명령을 하는지를 의미하는 것이다.
rax = *(int**)(rbp - 8)- 이는 대충 이런 C++코드 형태로 생각하면 된다.
- rbp-8을 counter의 주소값이 들어있다.
- rax에는 counter의 포인터를 저장한다.
- ecx는 rax의 값을 가져온다. (dword니까 int를 가져옴 ex: 5)
- 후에 ecx에 1을 add하고 그다음 더해진 값을 저장하는 개념이다.
근데 사실 이런 과정은 한번 다루고 싶어서 한거고 어셈블리를 몰라도 괜찮다.
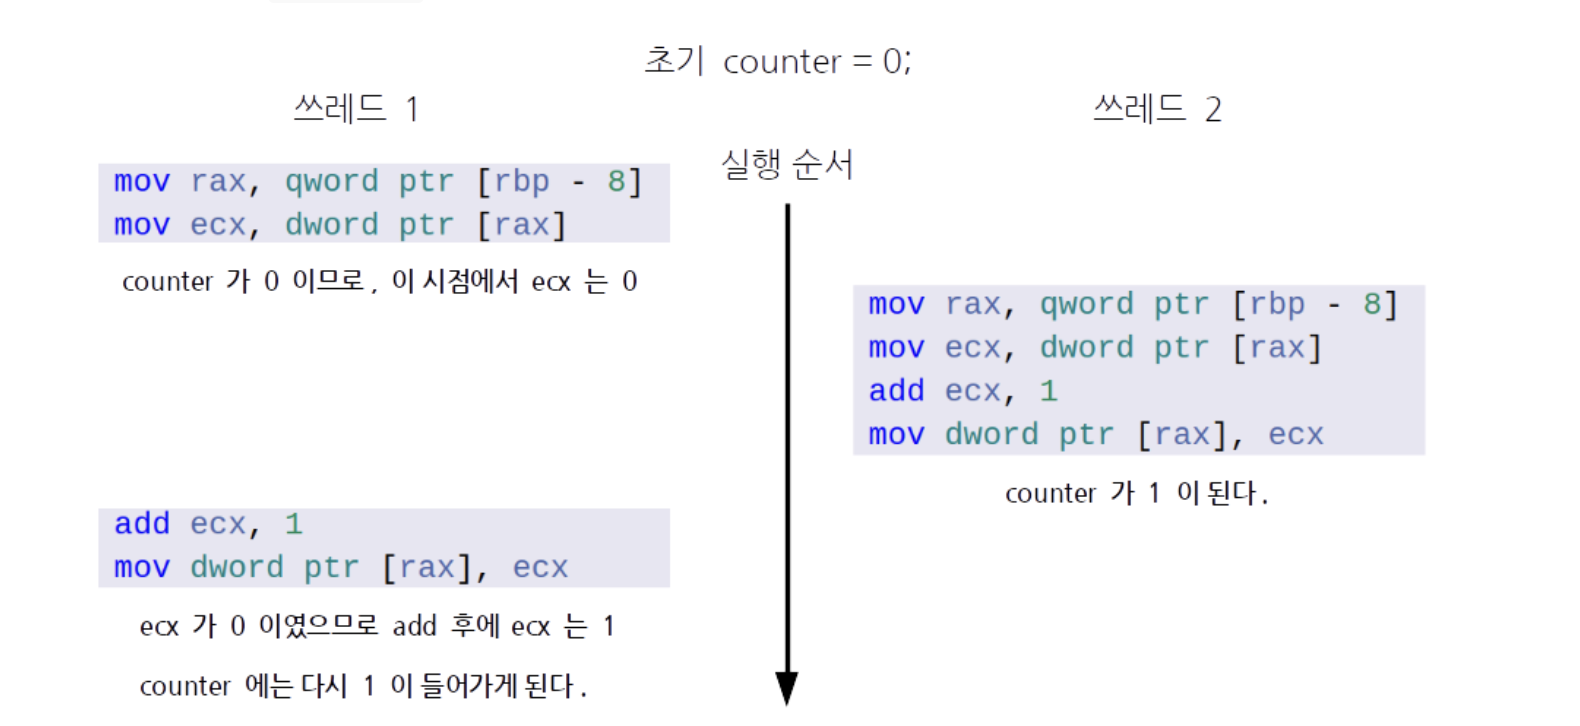
- 우리가 알아야 하는거는 단순히 1을 더하는 과정이 사실은
- 기존값을 읽고, 1을 올리고, 다시 저장하는 3가지 과정으로 나누어져 있다는 것이다.
- 따라서 저장하는 과정에서 다른 스레드로 인한 새로운 결과를 읽지 않으므로 race condition이 발생하는 것이다.
⚠️ 참고로 push_back()을 하는 과정도 이와 비슷하게 뒤에 추가하는 거지만 멀티 스레드에서는 충돌이 일어나게 된다. 이 이유에 대해서 생각을 해보자면 동적 배열같은 경우는 범위를 넘어서게 되면 그 공간을 복사하고 해제시켜 다른 여유 공간으로 이동하게 될텐데, 다른 스레드도 마찬가지로 영역을 해제하려고 시도하기 때문에 double free문제가 생기게 될것이다.
Atomic
이러한 race condition을 관리하기 위해서는 특정 데이터에 접근을 할때 한번에 하나의 스레드만 접근을 허락을 해줘야 하는데 이러한 방법으로는 Atomic을 이용한 관리가 있다. 어떻게 보면 가장 순수한 접근 제약이라고 보면 된다.
int SUM = 0;

void Add() {
    for (int i = 0; i < 10000; i++) {
        SUM++;
    }
}

void Sub() {
    for (int i = 0; i < 10000; i++) {
        SUM--;
    }
}

int main() {
	Add();
    Sub();
    cout << "result:" <<  SUM << endl;

    thread t1(Add);
    thread t2(Sub);

    t1.join();
    t2.join();
    cout << "thread result:" <<  SUM << endl;
}- 이렇게 동작시키게 되면, 위에서 배운 race condition으로 인해 스레드 후 결과는 0이 나오지 않을 것이다.
- 참고로 각 스레드는 각 스택영역을 가지지만 공통된 데이터영역과 힙영역을 가지기 때문에 전역으로 만들어진 SUM을 각 스레드가 건드리는 것이다.
#include<atomic>

atomic<int> SUM {0};

void Add() {
    for (int i = 0; i < 10000; i++) {
        //SUM++;
        SUM.fetch_add(1);
    }
}

void Sub() {
    for (int i = 0; i < 10000; i++) {
        //SUM--;
        SUM.fetch_sub(1);
    }
}

int main() {
	Add();
    Sub();
    cout << "result:" <<  SUM << endl;

    thread t1(Add);
    thread t2(Sub);

    t1.join();
    t2.join();
    cout << "thread result:" <<  SUM << endl;
}
result:0
thread result:0- 이렇게 자료형에 atomic을 감싸면 원자적으롣 동작하는걸 확인할 수 있다.
- 그리고 SUM++을 사용해도 되지만 SUM.fetch_add(1) 이렇게 사용하는 것도 가능하다.
- 이처럼 Atomic을 이용하면 원자적인 접근으로 한번에 하나만 접근할 수 있게 강제해주는 개념이라고 생각하면 된다.
⚠️ 참고로 STL같은거는 atomic으로 감쌀 수 없다. 그 이유는 STL에는 여러 기능이 있기 때문에 이 전체를 atomic으로 감싸는건 비효율적이고 STL들은 내부적으로 allocator가 있고 생성자 소멸자 등 원하는 스타일이 다르기 때문이라고 생각하면 된다.
Lock
이런 race condition을 제어하는 것 중 가장 대표적인것이 바로 Lock이다.
vector<int> v;

void Push() {
    for (int i = 0; i < 100000; ++i) {
        v.push_back(i);
    }
}

int main() {
    thread t1(Push);
    thread t2(Push);

    t1.join();
    t2.join();

    cout << "Vector size: " << v.size() << endl;
    return 0;
}- 자 그럼 이러한 코드를 실행하면 vector에 20만개의 데이터가 생기게 된다.
- 하지만 막상 실행해보면 기대와는 달리 바로 크러시가 나게 된다.
- 일단 짚고 넘어가야 하는게 기존 STL들은 모두 멀티 스레딩 환경에서 오류가 난다고 생각해야 한다.
- 암튼 문제는 위와 동일하다. 범위를 초과하게 되면 원래라면 다른 메모리 공간에 이를 복사하고 크기를 늘린다음에 그 뒤에 넣게 된다. 후에 원래 메모리 공간을 비워주게 될텐데. 이 과정에서 멀티 스테드로 해버린다면 서로 넣으려고 하거나 다른 스레드에 의해 이미 비워졌는데 넣으려고 시도한다면? 당연히 문제가 생길 것이다.
- 이렇게 서로 비우려고 하는걸 더블프리 문제라고 부른다.
v.reserve(200000)- 그러면 이렇게 미리 20만개의 공간을 만들어 두고 이걸 실행하면 문제가 없지 않을까?
- 이것도 당연하게 몇개의 vector은 소실 될 것이다. 왜냐면 같은 인덱스에 서로 생성하려고 중복이 되는 경우가 있을 수 있기 때문이다. 이는 + 연산처럼 바로 수행이 되지않고 실제로는 여러 스텝으로 나누어서 동작되기 때문에 일어나는 일이다.
- 이를 해결하는 방법은 락을 걸어서 임계구역을 제한하는 것인데,
mutex를 사용하면 된다.
Mutex
한번에 하나의 스레드만 자원에 접근할 수 있게 해주는 잠금 장치 객체.
- OS부분에서 한번 다뤘는데 세마포어는 특정 N개를 허락하기 때문에 int로 잠금을 확인하는 느낌이고 Mutex는 한개의 객체만 허락하기 때문에 bool타입으로 잠금을 확인하는 거라고 생각하면 된다.
- 결론: 짱짱 좋은 lock = Mutex
#include <mutex>  // mutex 를 사용하기 위해 필요

void worker(int& result, mutex& m) {
  for (int i = 0; i < 10000; i++) {
    m.lock();
    result += 1;
    m.unlock();
  }
}

int main() {
  int counter = 0;
  mutex m;  // 우리의 mutex 객체

  vector<thread> workers;
  for (int i = 0; i < 4; i++) {
    workers.push_back(thread(worker, ref(counter), ref(m)));
  }

  for (int i = 0; i < 4; i++) {
    workers[i].join();
  }

  cout << "Counter 최종 값 : " << counter << endl;
}- 아까 위와 같은 코드는 그냥 mutex객체를 받아서 lock()과 unlock()을 수행하면 스무스 하게 동작 시킬 수 있다.
- 당연하지만 unlock()을 빼먹으면 다른 애들은 평생 기다려야 한다.
m.lock();
m.lock();
// TODO 뭔가 처리
function();
m.unlock();
m.unlock();- 참고로 mutex는 이런식으로 재귀적으로 락을 걸 수 없다. (CRASH 발생)
- 게다가 항상 lock을 했으면 unlock으로 풀어줘야 하는데 중간에 조건문에 의해 break를 넣거나 하는 식이면 상당히 귀찮아질 것이다. 따라서 이를 해결할 수 있는게 바로
lock_guard이다.
lock_guard
void worker(int& result, mutex& m) {
  for (int i = 0; i < 10000; i++) {
    // lock 생성 시에 m.lock() 을 실행한다고 보면 된다.
    lock_guard<std::mutex> lock(m);
    result += 1;

    // scope 를 빠져 나가면 lock 이 소멸되면서
    // m 을 알아서 unlock 한다.
  }
}- 항상 unlock()하기에 실수도 하기때문에 c++에서는 lock_gurad를 제공한다.
- 이는 코드블록(scope)를 빠져나가면 알아서 unlock을 수행하는 것이다.
- Mutex를 그냥 lock, unlock을 하는 경우는 디테일하게 성능을 올리고 싶을 때 사용하지만 대부분의 상황에서는 lock_guard를 사용하는게 정신건강에 이롭다.
- lock_guard는
RAII라는 원칙에 따라 동작하는건데 쉽게 말하자면 생성자에서 락을 걸고 소멸자에서 락을 푸는 패턴으로 만들어 졌다고 보면 된다. - 직접 만들어 보자면 이런식으로 만들 수 있을 것이다.
template<typename T>
class LockGuard {
public:
    LockGuard(T& m) {
        _mtx = &m;
        _mtx->lock();
    }
    ~LockGuard() {
        _mtx->unlock();
    }
private:
    T* _mtx;
};

vector<int> v;
mutex m;

void Push() {
    for (int i = 0; i < 100000; ++i) {
        LockGuard<mutex> lg(m);
        v.push_back(i);
    }
}

int main() {
    thread t1(Push);
    thread t2(Push);

    t1.join();
    t2.join();

    cout << "Vector size: " << v.size() << endl;
    return 0;
}- 이렇게 락을 받아서 생성자에서 락을 걸고 소멸자에서 락을 풀기 때문에 선언된 스코프 내에서 락을 유지하게 될 것이고 만약에 스코프를 벗어나게 되면 알아서 스택을 정리하면서 소멸자가 호출되면서 락을 해제할 것이다.
- 이런 lock_guard는 기본적으로 제공되기 때문에 가져다가 사용하면 된다.
void worker1(std::mutex& m1, std::mutex& m2) {
  for (int i = 0; i < 10000; i++) {
    std::lock_guard<std::mutex> lock1(m1);
    std::lock_guard<std::mutex> lock2(m2);
    // Do something
  }
}

void worker2(std::mutex& m1, std::mutex& m2) {
  for (int i = 0; i < 10000; i++) {
    std::lock_guard<std::mutex> lock2(m2);
    std::lock_guard<std::mutex> lock1(m1);
    // Do something
  }
}

int main() {
  int counter = 0;
  std::mutex m1, m2;  // 우리의 mutex 객체

  std::thread t1(worker1, std::ref(m1), std::ref(m2));
  std::thread t2(worker2, std::ref(m1), std::ref(m2));

  t1.join();
  t2.join();

  std::cout << "끝!" << std::endl;
}- 근데
lock_guard를 사용한다고 해서 데드락이 회피되는 것은 아니다. - 서로가 서로의 lock을 기다리면 당연히 데드락이 발생한다.
void worker2(std::mutex& m1, std::mutex& m2) {
  for (int i = 0; i < 10000; i++) {
    while (true) {
      m2.lock();

      // m1 이 이미 lock 되어 있다면 m2에 관한 락을 푼다.
      if (!m1.try_lock()) {
        m2.unlock();
        continue;
      }

      std::cout << "Worker2 Hi! " << i << std::endl;
      m1.unlock();
      m2.unlock();
      break;
    }
  }
}- 이는 worker2 부분에서 m1이 락이 걸려있지 않을때만 락을 걸고 할일을 하면 된다.
- 이미 락이 걸려있으면 비켜주는 개념으로 접근하면 데드락은 피할 수 있을 것이다.
unique_lock
lock_guard 말고도 unique_lock이라는 wrapper도 존재한다. 큰 차이점이라고 한다면 유연성에 있다.
mutex m;
void Flexible() {
    unique_lock<mutex> lock(m, defer_lock);  // lock 안 함
    if (need_lock) lock.lock();              // 조건 lock

    // 작업1
    lock.unlock();                           // 임시 unlock
    DoIO();                                  // IO 중 mutex 풀기

    lock.lock();                             // 재lock
    // 작업2
} // 자동 unlock- unique_lock같은 경우는 기본은 lock_guared처럼 호출이 되면 락이 걸리지만 unique_lock(defer_lock) 이런식으로 모드를 바꾸면 호출이 될때 바로 잠기는 것이 아니라 따로 lock을 호출해야 그제서야 락이 걸리게 할 수 있다. (유연한 처리 가능)
- 대부분의 경우는 lock_guard를 사용하기 때문에 일단 이렇게만 알고 넘어가겠다.
Lock 구현
이런 락을 구현하는 방법에는 크게 3가지가 존재하게 된다.
- Spin Lock
- Sleep 방식
- Event 방식
- Spin방식은 쉽게 말해서 반복문으로 계속 락을 얻기 위해 시도하고 있는 개념이다.
- Sleep 방식은 락 획득에 실패하면 sleep 상태가 되는거고, sleep시간을 정해 중간중간 확인하는 방식이다. 이 방식은 spin과 마찬가지로 반복적으로 동작을 한다. 만약 sleep시간을 무한으로 하게 되면 OS가 임의로 중간중간 깨우면서 확인하게 된다.
- Event 방식은 OS에게 예약을 걸어두고, 선점하던 스레드가 끝나면 OS에 끝났다고 알려줘서 그 후에 OS가 예약을 걸어둔 스레드에게 알려주는 것이다.
Spin Lock (with CAS)
class SpinLock {
public:
    void lock() {
        while (_lock) {

        }
        _lock = true;
    }

    void unlock() {
        _lock = false;
    }
private:
    bool _lock = false;
};

int SUM = 0;
SpinLock spinlock;
void Add() {
    for (int i = 0; i < 10000; i++) {
        spinlock.lock();
        SUM++;
        spinlock.unlock();
    }
}

void Sub() {
    for (int i = 0; i < 10000; i++) {
        spinlock.lock();
        SUM--;
        spinlock.unlock();
    }
}

int main() {
    thread t1(Add);
    thread t2(Sub);

    t1.join();
    t2.join();

    cout << "result:" <<  SUM << endl;
    return 0;
}- spin lock을 구현한다면 아마 이런 형태로 구현하게 될 것이다.
- 멤버변수로 bool 타입을 가지고, 이걸 토대로 true, false를 하면서 무한 대기를 하게 될 것이다.
- 하지만 이 코드를 실행하면 우리 기대와 달리 엉뚱한 값이 나오게 된다.
- 그 이유는 while(){}을 동시에 여러 쓰레드가 빠져나가서 서로 _lock을 true로 바꾸며 본인이 승리자라고 착각할 수 있기 때문이다.
- 그러면 이걸 해결하기 위해서는 atomic을 사용하면 될 것이다.
class SpinLock {
public:
    void lock() {
        bool expected = false;
        bool desired = true;

        while (_lock.compare_exchange_strong(expected, desired) == false) {
            expected = false;
        }
    }

    void unlock() {
        _lock.store(false);
    }
private:
    atomic<bool> _lock{ false };
};- 이걸 해결하기 위해서는 CAS(Compare-And-Swap)계열의 함수를 사용해야 한다.
- CAS는 락프리에서 매우 중요하게 사용되는데 쉽게 말해서 “비교해서 같으면 값을 바꾼다.”라는 동작 원리를 가지고 있다.
compare_exchange_strong이라는 것이 대표적인 CAS 함수이다.- 여기서 알아야 하는 점은 첫번째 expected인자의 레퍼런스를 받기 때문에 값이 바뀐다는 점이다. 그러면 어떻게 바뀔지가 매우 중요하게 된다.
if (_lock == expected)
{
	expected = _lock;
	_lock = desired;
    return true;
}
else
{
	expected = _lock;
}- 일단 CAS의 의사코드를 한번 먼저 살펴보자.
_lock이 우리가 기대하는expacted값과 같다면desired값으로 바꾸는 것이다.- 여기서 중요한거는 결과가 어떻게 나오든
expacted가_lock의 값으로 변환이 된다는 것이다. - 그래서 반복문에서는 다시
expacted값을 false로 초기화 해주고 있는 것이다. - 그리고 반복문을 돌다가
_lock이 false가 되면 이걸 true(desired)로 바꿔주고 반복문을 빠져나가게 되는 것이다. - 이 모든 과정은 atomic하게 이루어지게 된다.
Sleep
- 사실 Sleep에 대해서 좀 알기 위해서는 스케줄링에 대해서 알면 좋다.
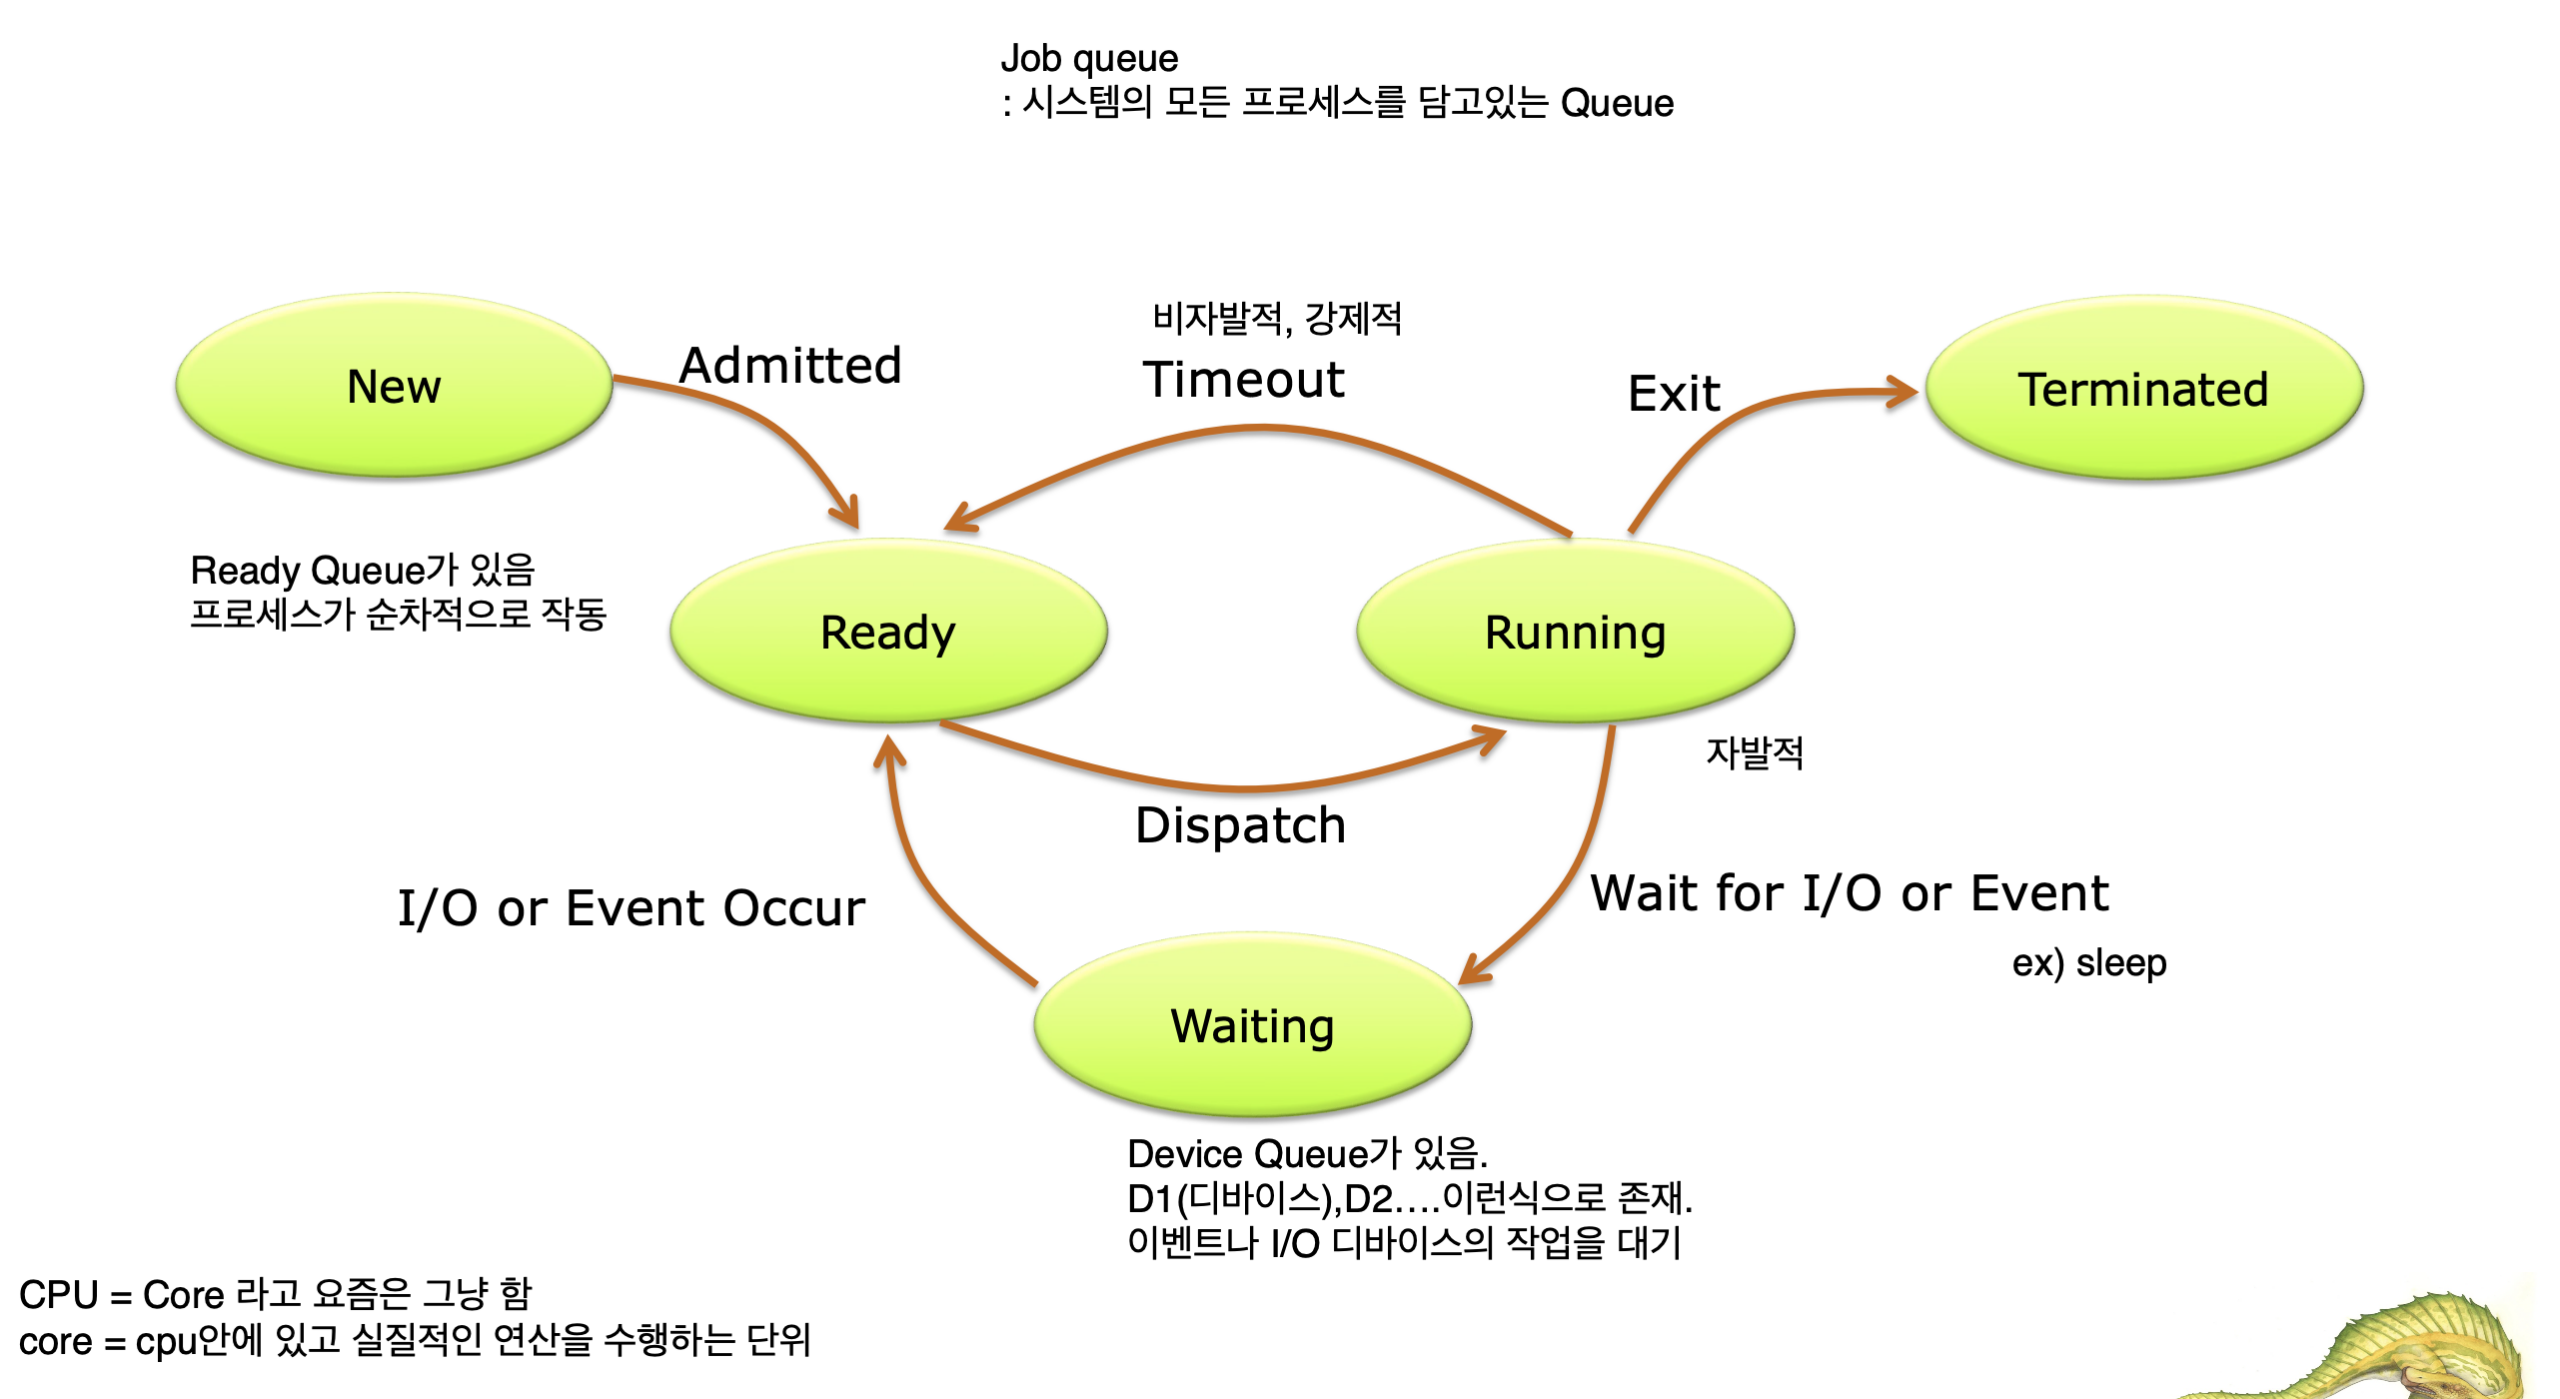
- 이렇게 Ready상태이다가 실행중이 되는데, 여기서 자발적으로 system call을 통해 wait상태로 전환이 되고, 이게 끝나면 다시 Ready큐에 들어가면서 다음 차례를 기다리게 되는 개념이다.
- 여기서 system call이란 내 프로그램이 커널에 명령하게 되는 그런 것들을 말하는 거라고 생각하면 된다.
class SpinLock {
public:
    void lock() {
        bool expected = false;
        bool desired = true;

        while (_lock.compare_exchange_strong(expected, desired) == false) {
            expected = false;

            this_thread::sleep_for(100ms);
        }
    }

    void unlock() {
        _lock.store(false);
    }
private:
    atomic<bool> _lock{ false };
};- 사용은 매우 간단하게 그냥
sleep_for()를 이용하면 알아서 원하는 시간만큼 대기하다가 작업을 이어서 하게 된다. - 그래서 이전 스핀락에서는 계속 반복문을 확인하기 때문에 불필요한 연산이 지속적으로 생기게 될것이다. (바로 락을 얻으면 이상적이지만 그렇지 않음)
- 그래서 정해진 시간만큼 쉬고 그다음에 확인하게 하는 것이다.
- 참고로
this_thread::yield()도 있는데 이거는 그냥sleep_for(0ms)과 같다고 생각하면 된다.
Event
이벤트를 이용한 동기화 방법이 사실 가장 좋다. 그 이유는 웬만한 상황에서 높은 효율을 보여주기 때문이다. 물론 락을 오래 점유하지 않는 상황에서는 context switch비용이 생각보다 크기 때문에 스핀락이 유리하겠지만 그런 경우는 많이 없다.
- Event는 기본적으로 2가지 상태가 있다. 바로 signal 이랑 unsignal 상태이다. 시그널이 되어있으면 잠들어있는 스레드를 깨우고 아니면 냅두는 개념이다.
- 시그널 상태를 키는 것은 그 데이터를 점유하고 있던 스레드가 나가면서 시그널의 상태를 바꾸게 된다. 그러면 OS는 그걸 보고 대기중이던 스레드한테 알려주는 것이다.
mutex m;
queue<int32> q;

void Producer()
{
	while (true)
	{
		{
			unique_lock<mutex> lock(m);
			q.push(100);
		}
		this_thread::sleep_for(chrono::milliseconds(1));
	}
}

void Consumer()
{
	while (true)
	{
		unique_lock<mutex> lock(m);
		if (!q.empty())
		{
			int32 value = q.front();
			q.pop();
			cout << value << endl;
		}
	}
}

int main()
{
	thread t1(Producer);
	thread t2(Consumer);

	t1.join();
	t2.join();
}- 이런 코드가 있다면 정상적으로 동작하는걸 확인할 수 있다.
- 근데 여기서 만약에 어떤 producer의 작업이 엄청 가끔 한번씩만 넣어주는 작업이라 1시간에 한번만 넣어준다면 어떨까?
- Consumer는 그 사실도 모른채 계속해서 무한루프를 돌면서 자원을 낭비하고 있을 것이다.
- 따라서 이런경우는 커널 오브젝트에 작업을 위임하고 뭔가 오면 신호를 주게끔 만들 어 주면 효율적으로 관리할 수 있을 것이다.
- 참고로 커널로 넘기게 되면 context switch 비용이 발생하긴 하지만 커널에서는 여러 디스패쳐와 스케줄링으로 효율적으로 작업이 왔는지 등등을 검사할 수 있다.
mutex m;
queue<int32> q;
HANDLE handle;

void Producer()
{
	while (true)
	{
		{
			unique_lock<mutex> lock(m);
			q.push(100);
		}
		::SetEvent(handle); // 신호를 signal 상태로 변경
		this_thread::sleep_for(chrono::milliseconds(1));
	}
}

void Consumer()
{
	while (true)
	{
		::WaitForSingleObject(handle, INFINITE); // signal 상태가 될 때까지 대기

		unique_lock<mutex> lock(m);
		if (!q.empty())
		{
			int32 value = q.front();
			q.pop();
			cout << value << endl;
		}
	}
}

int main()
{
	// 커널 오브젝트
	// Useage Count (이 오브젝트를 몇명이 사용하고 있는지)
	// Signal / Non-Signal (신호 / 비신호)
	// Auto Reset / Manual Reset (자동 리셋 / 수동 리셋)
	handle = ::CreateEvent(NULL/*보안 속성*/, FALSE/*manual Reset*/, FALSE, NULL);
	thread t1(Producer);
	thread t2(Consumer);

	t1.join();
	t2.join();
}- 이벤트를 사용하기 위해서는 가장 기본적으로
CreateEvent함수를 이용해서 커널 오브젝트를 만든다. - 이렇게 되면 handle이라는 값을 넘겨주게 되는데 이거는 그냥 커널 오브젝트의 번호표(int)라고 생각하면 된다.
- 그러고 나서
SetEvent를 통해서 신호를 주게 되면,WaitForSigleObjece와 같이 신호를 기다리고 있던 부분에서 통과가 되면서 작업을 수행할 수 있는 것이다. - 이렇게 해서 실제로 작업해보면 cpu의 사용률이 현저히 떨어진 것을 확인할 수 있다. (야호~)
Condition Variable
condition variable은 특정 조건이 될 때 까지 스레드를 효율적으로 대기시키는 동기화 도구이다. 참고로 이벤트와 비슷하게 동작을 하는 개념인데, 커널 오브젝트는 아니고 user-level 오브젝트이다. 따라서 뭔가 자주 일어나는 그런 작업이라면 유용하게 사용할 수 있다.
그리고 그냥 커널오브젝트와의 차이점이라고 한다면 보통 락이랑 짝지어서 사용한다. 아래 예시를 살펴보자.
condition_variable cv;

void Producer()
{
	while (true)
	{
		{
			unique_lock<mutex> lock(m);
			q.push(100);
		}

		cv.notify_one(); // wait중인 스레드 1개를 깨운다.
	}
}

void Consumer()
{
	while (true)
	{
		unique_lock<mutex> lock(m);
		cv.wait(lock, []() {return q.empty() == false;});
		// 1.락을 건다.
		// 2. 조건 확인
		// IF 조건이 True -> 빠져나와서 이어서 코드를 진행
		// IF 조건이 False -> 락을 풀고 대기 상태로 들어감.
		{
			int32 value = q.front();
			q.pop();
			cout << value << endl;
		}
	}
}- 이전 코드와 달라진 점은 condition_variable을 사용한다는 점이다.
- 기본 개념은 락을 잡고 condition variable을 바꾸고, 락을 풀고 조건변수를 통해 다른 스레드에게 알리면 되는 것이다.
- 이렇게 되면 바로 대기 상태로 빠지는 것이 아니라 조건을 확인해서 만족을 안하면 락을 풀고 대기상태가 된다는 것이다.
- 자 그러면 알다싶이 락을 지금 wait함수 내부에서 풀수 있는 가능성이 있기 때문에 “무조건” unique lock을 받아줘서 나중에 상태를 바꿀 수 있게 해줘야 한다. (lock_guard는 오류).
- 다시 wait을 만나면 lock을 다시 걸고 확인을 하고 만족하면 그때 이제 작업을 수행하게 되는 것이다.
Producer – Consumer 패턴
대학교 OS 과목에서 배웠던 걸 그대로 다시 공부하니까 참 신기하면서도 진작 할껄 그랬다는 생각이든다.
- 이 패턴은 말 그대로 생성하는 것과 소비하는 것을 나눈다는 개념이다.
- FIFO(선입선출)로 보통 설계하기 때문에
queue를 이용한다.
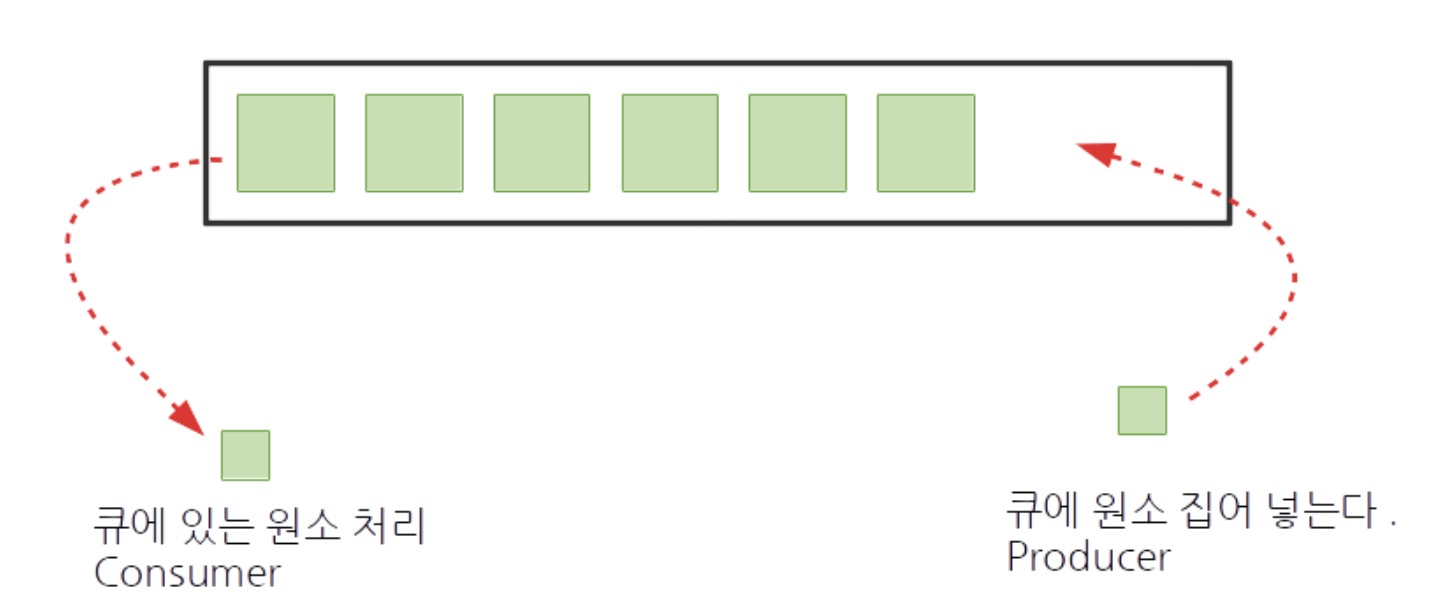
- 딱 이런 개념이다. 원소를 큐에 넣고 소비하기.
#include <chrono>
#include <iostream>
#include <mutex>
#include <queue>
#include <string>
#include <thread>
#include <vector>

void producer(std::queue<std::string>* downloaded_pages, std::mutex* m,
              int index) {
  for (int i = 0; i < 5; i++) {
    // 웹사이트를 다운로드 하는데 걸리는 시간이라 생각하면 된다.
    // 각 쓰레드 별로 다운로드 하는데 걸리는 시간이 다르다.
    std::this_thread::sleep_for(std::chrono::milliseconds(100 * index));
    std::string content = "웹사이트 : " + std::to_string(i) + " from thread(" +
                          std::to_string(index) + ")\n";

    // data 는 쓰레드 사이에서 공유되므로 critical section 에 넣어야 한다.
    m->lock();
    downloaded_pages->push(content);
    m->unlock();
  }
}

void consumer(std::queue<std::string>* downloaded_pages, std::mutex* m,
              int* num_processed) {
  // 전체 처리하는 페이지 개수가 5 * 5 = 25 개.
  while (*num_processed < 25) {
    m->lock();
    // 만일 현재 다운로드한 페이지가 없다면 다시 대기.
    if (downloaded_pages->empty()) {
      m->unlock();

      // 10 밀리초 뒤에 다시 확인한다.
      std::this_thread::sleep_for(std::chrono::milliseconds(10));
      continue;
    }

    // 맨 앞의 페이지를 읽고 대기 목록에서 제거한다.
    std::string content = downloaded_pages->front();
    downloaded_pages->pop();

    (*num_processed)++;
    m->unlock();

    // content 를 처리한다.
    std::cout << content;
    std::this_thread::sleep_for(std::chrono::milliseconds(80));
  }
}

int main() {
  // 현재 다운로드한 페이지들 리스트로, 아직 처리되지 않은 것들이다.
  std::queue<std::string> downloaded_pages;
  std::mutex m;

  std::vector<std::thread> producers;
  for (int i = 0; i < 5; i++) {
    producers.push_back(std::thread(producer, &downloaded_pages, &m, i + 1));
  }

  int num_processed = 0;
  std::vector<std::thread> consumers;
  for (int i = 0; i < 3; i++) {
    consumers.push_back(
        std::thread(consumer, &downloaded_pages, &m, &num_processed));
  }

  for (int i = 0; i < 5; i++) {
    producers[i].join();
  }
  for (int i = 0; i < 3; i++) {
    consumers[i].join();
  }
}- producer은 총 5개를 순차적으로 push한다. (총 25개)
- consumer은 순차적으로 이를 소비 (출력) 한다.
- 이때 락을 운용해서 race condition을 방지한다.
- 참고로 consumer이랑 producer이 같은 mutex를 운용하고 있기 때문에 consumer가 대기 해야 하는 상황이면 바로 락을 반납해야 producer가 생성할 수 있다.
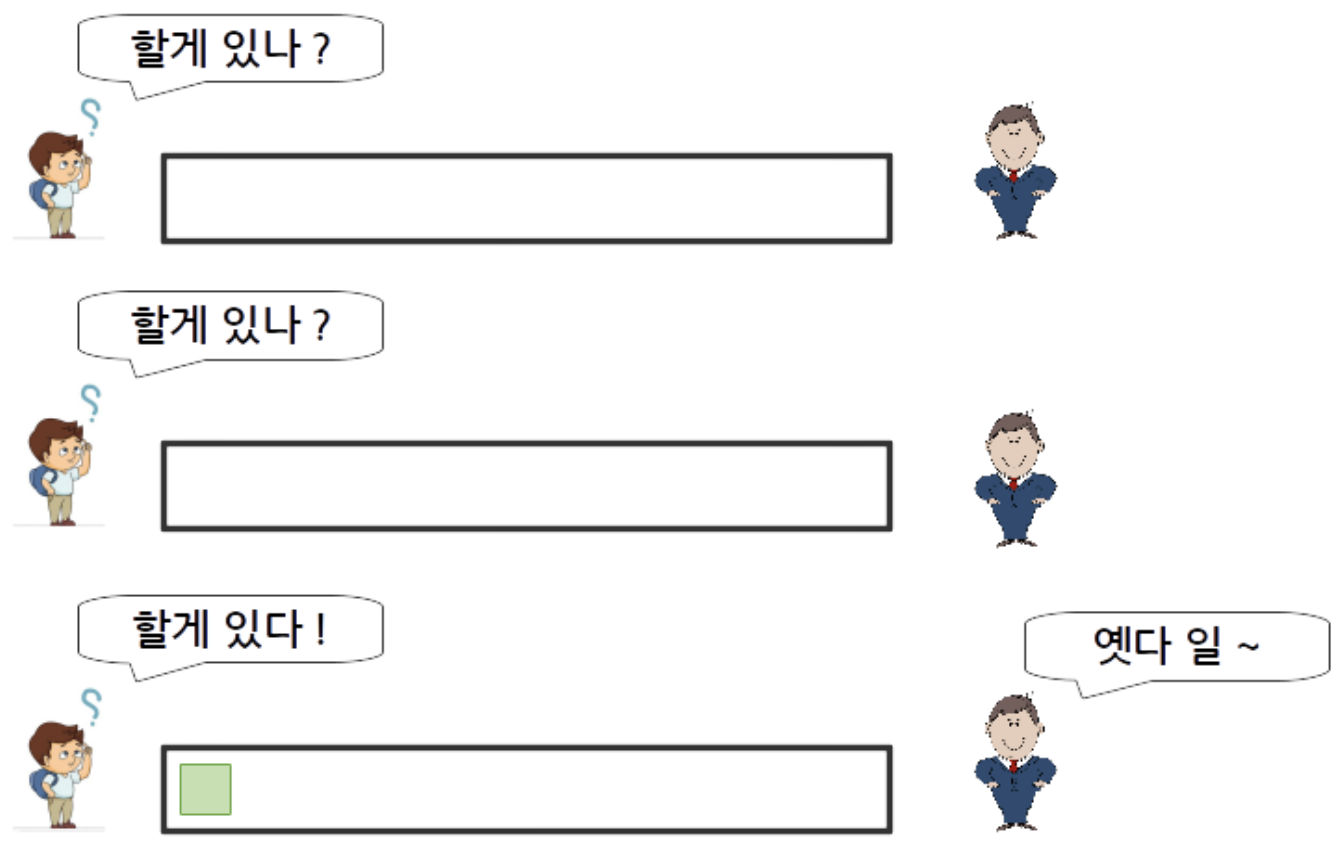
- 하지만 지금 consumer은 매우 비효율적인데, 그 이유는 정해진 시간마다 일이 있는지 계속 일어나서 확인하고 있다는 것이다.
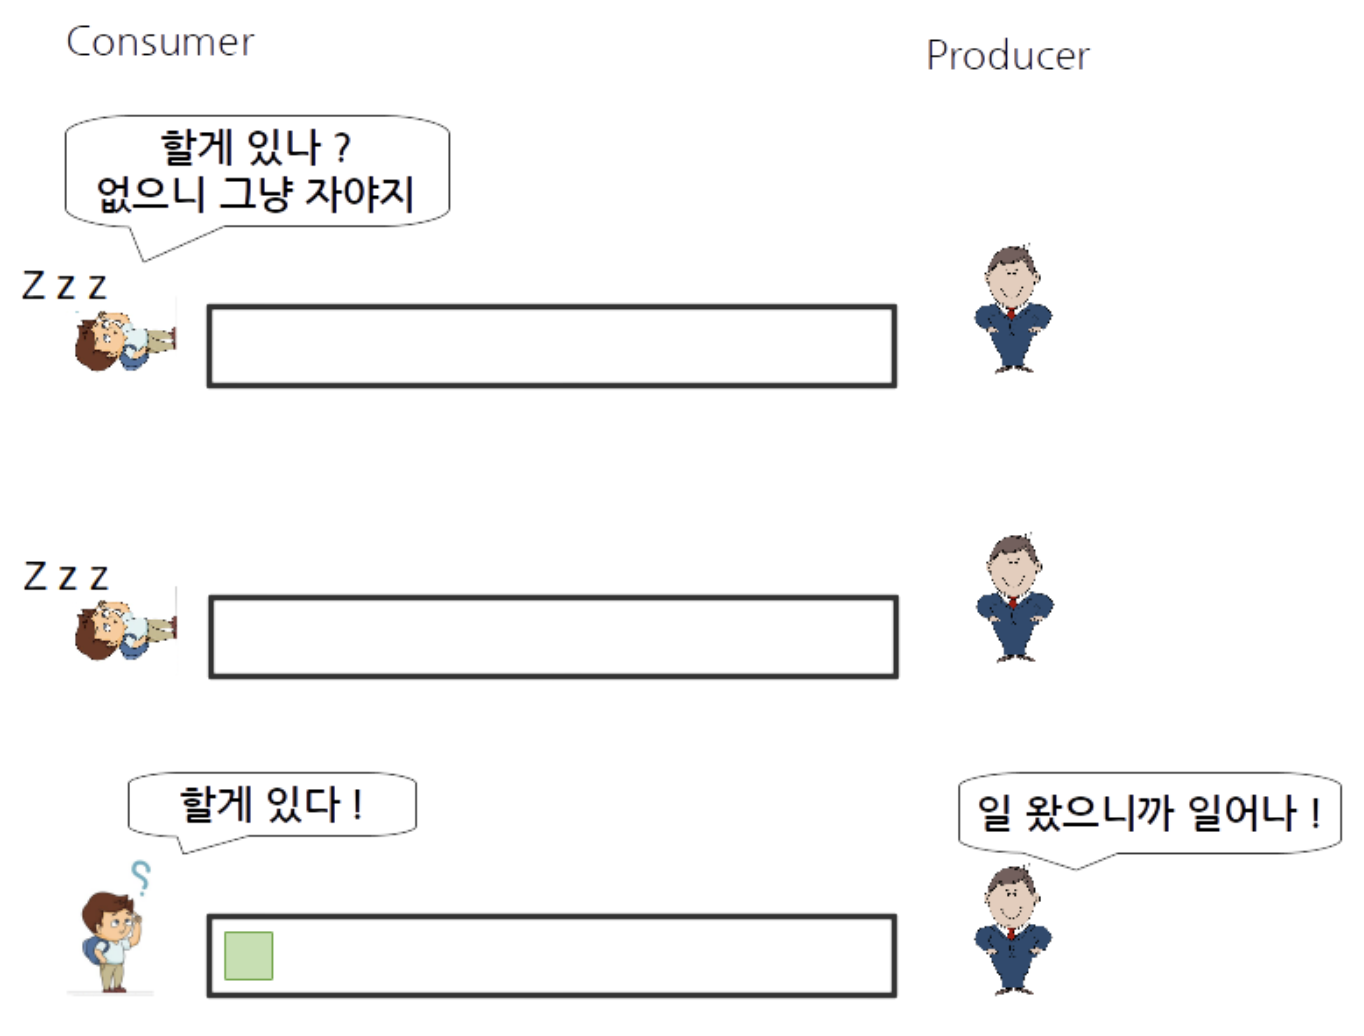
- 아마 이런식으로 일이 없으면 consumer 스레드는 그냥 자고 있고, producer에서 일이 왔다는 걸 알리는게 가장 이상적일 것이다.